 微域生光
设计挑战
可以运行评估 却不知道如何采取行动
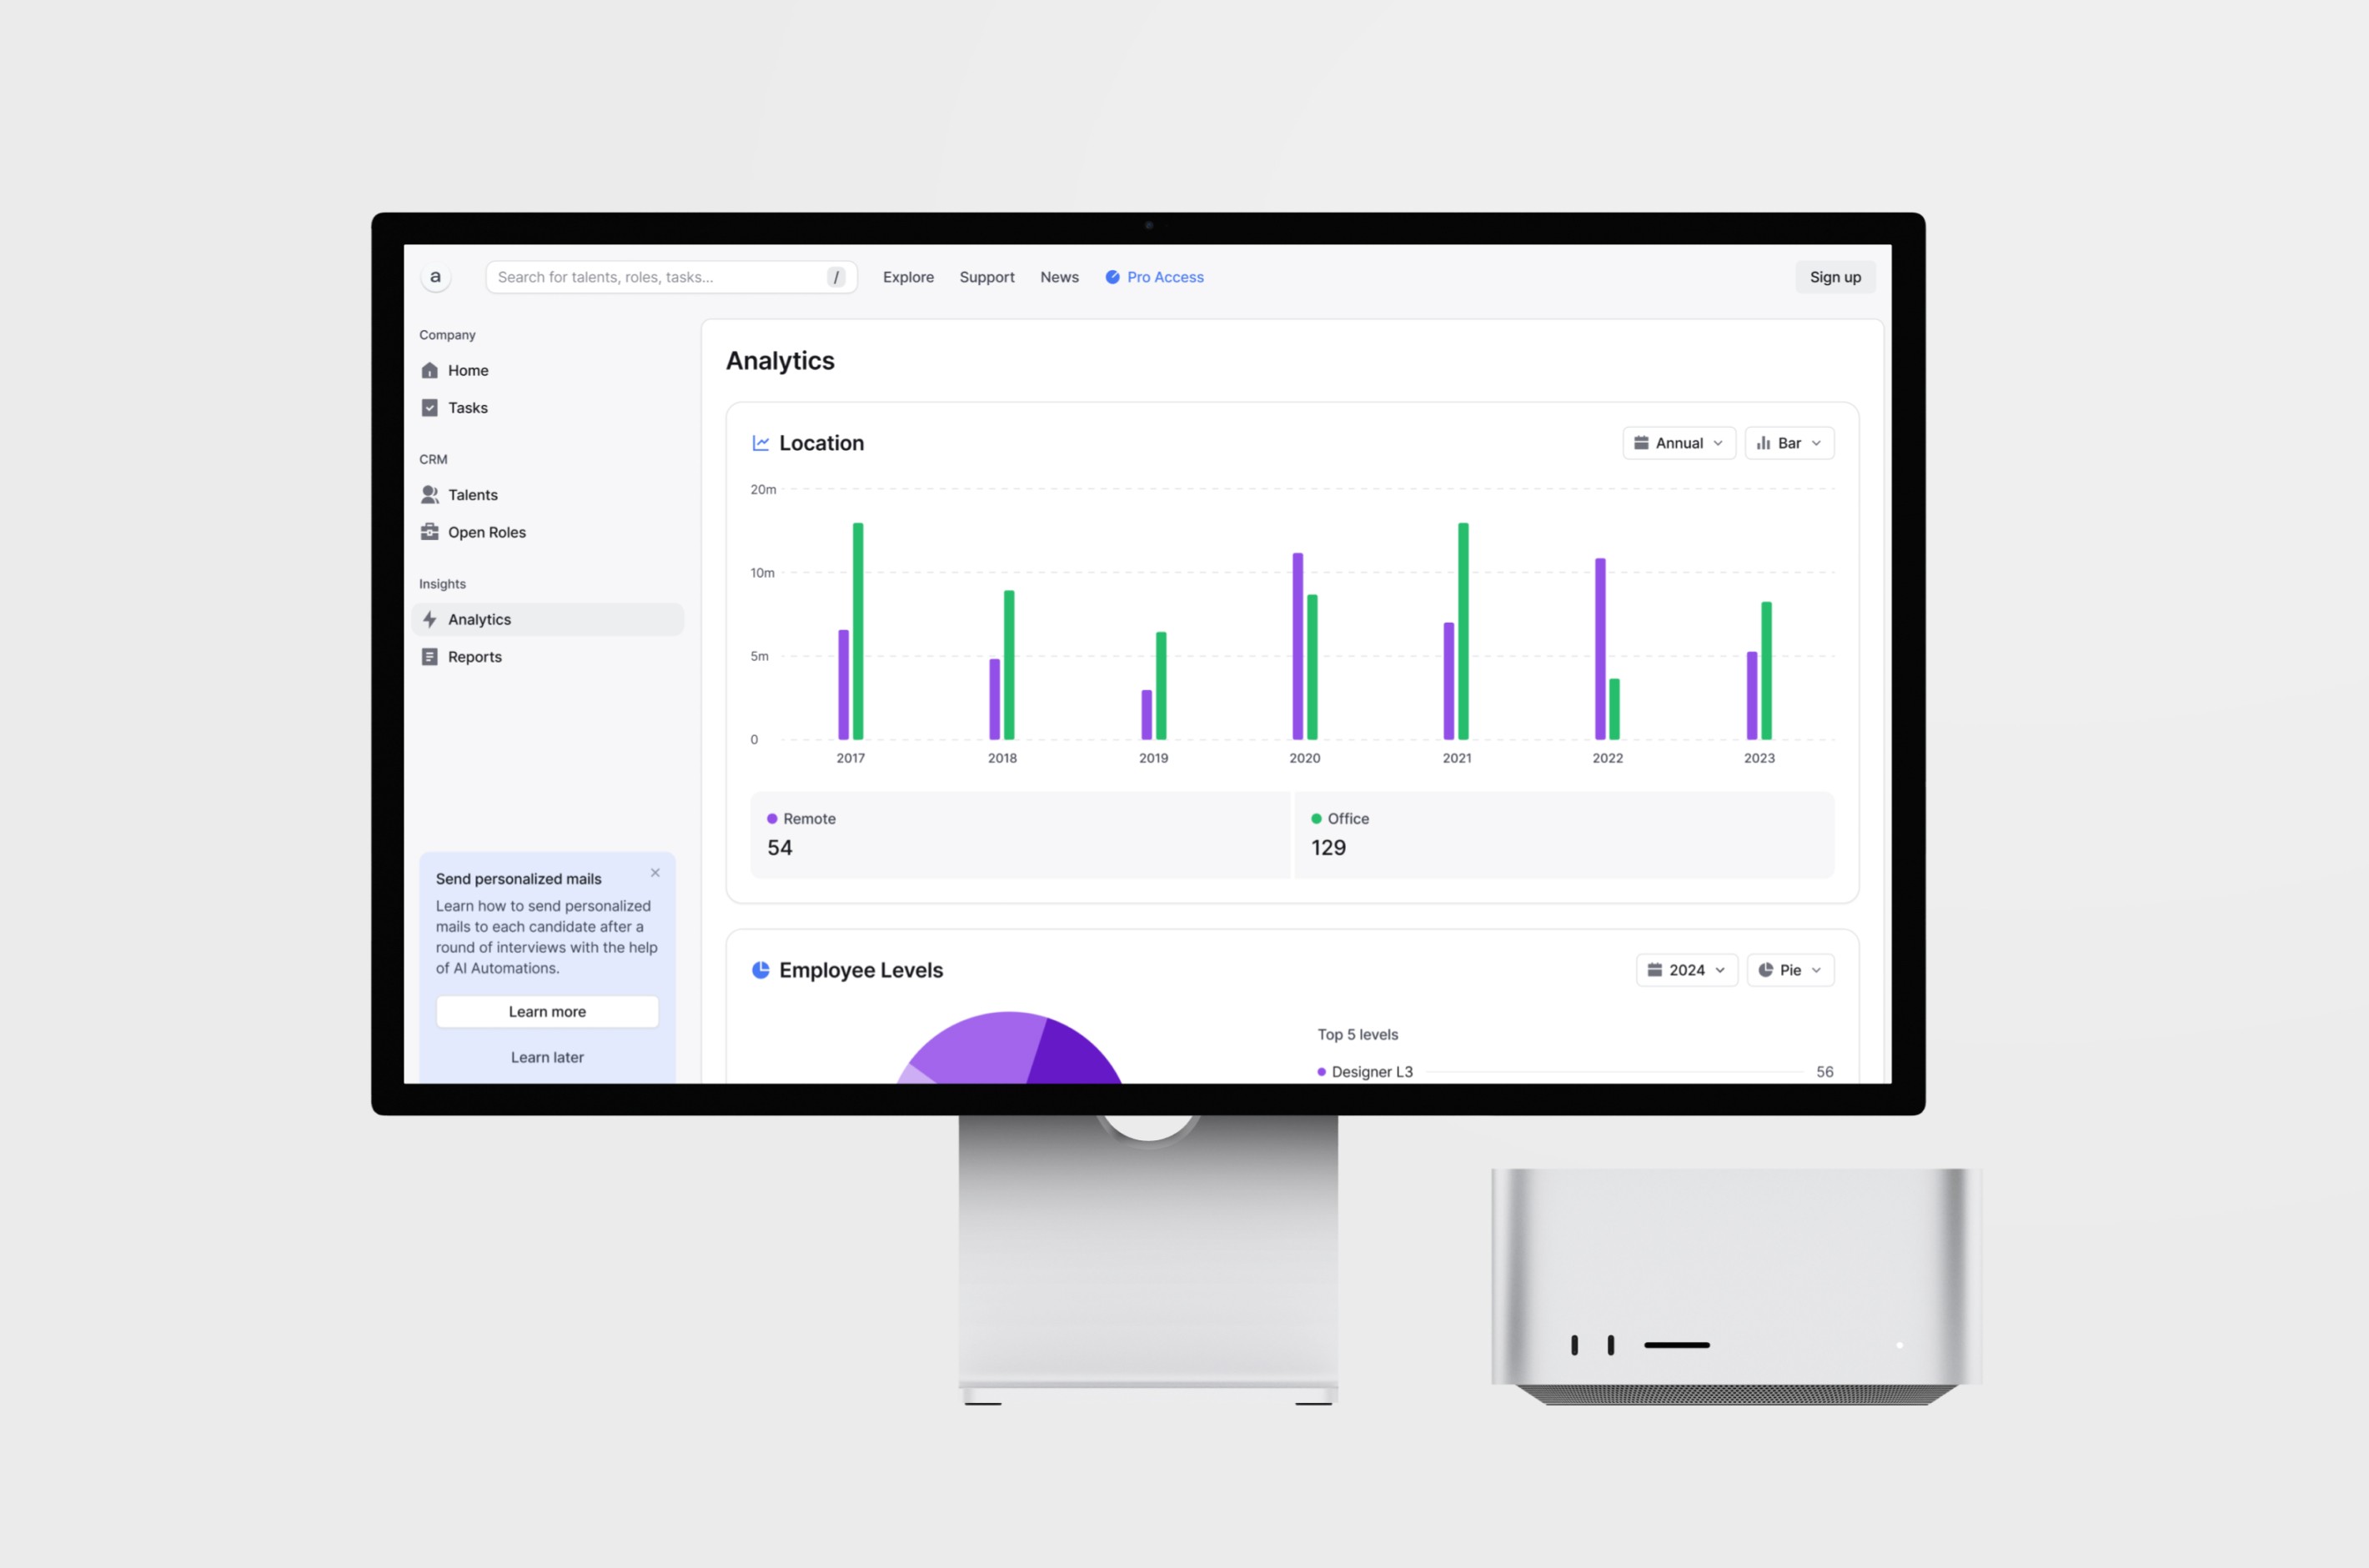
一次运行显示通过率 82%,修改提示词后变成 79%。仅有三个百分点的差异,无法判断哪类行为退化,或是否只是评分器噪声。用户于是忽略数字,回到表格里手动阅读输出。
“我知道哪里变差了,却不知道是什么,只能再读五十条输出。”——使用平台六个月的工程师
设计过程
以比较而非单次运行为中心,默认并排展示两次结果。
按失败行为聚类,将四百行失败转成十二个可理解的类别,如拒答、虚构引用或格式错误。
先人工评分二十个例子,再比较自动评分的一致性,有意放慢初始设置以建立信任。
通过功能开关移除访问最多却帮助最少的指标仪表盘,一个月内没人要求恢复。
解决方案
默认进入最近两次运行的比较视图,按最大行为变化排序,总分留在次要位置。
每个失败簇提供清晰名称、数量、相较上次的变化和三个代表例子。
键盘优先评分:J/K 移动,1—3 评分,无需反复加载页面,二十个例子约四分钟。
从失败用例一键查看输入、输出、评分依据和 token 成本,先判断评分器是否出错。
项目结果
发布后两个月,第六周留存从 31% 升至 58%,将评估接入 CI 的团队数量超过翻倍。评估只有在每次变更时运行,才能持续产生价值。
如果重来:研究员定义的聚类适合聊天与 RAG,却难以描述智能体工具调用序列的错误。这在六周内成为首要支持需求,应更早让用户自定义聚类。原站末尾的协作清单指标与本案例主题存在不一致,英文保留原文,中文明确记录这一限制。
第六周留存31% → 58%
接入 CI 的团队>2×